إعداد: د. طارق محمد الشامي
قسم الرياضيات – جامعة صنعاء
تُعدّ الرياضيات، عبر تاريخها الطويل، لغةَ الفكر الإنساني وأحدَ أعمق أدواته لفهم الكون وبناء المعرفة. وتشكّل الرياضيات البحتة، إلى جانب الرياضيات التطبيقية والإحصاء، الفروعَ الرئيسة للرياضيات من الناحية التنظيمية. وتُعنى الرياضيات البحتة بدراسة المفاهيم المجردة ضمن البنى الرياضية، ثم استنباط النظريات والنتائج التي تربط هذه المفاهيم وتصف خصائصها وطبيعة العلاقات بينها. غير أن هذه المفاهيم المجردة أصبحت لاحقًا، وبعد ظهورها بمدة طويلة، أدواتٍ لا غنى عنها في كثير من المجالات التي تخدم الإنسان وتُسهم في تسهيل إنجاز مهامه وتسريعها، كتحليل البيانات، والتصوير الطبي، والذكاء الاصطناعي، والاقتصاد، وغيرها.
ويمكن تلخيص هذه الفكرة في صورة بسيطة: قد يبدأ الرياضي بسؤال يبدو بعيدًا عن الواقع، فيبني تعريفًا أو نظرية أو بنية رياضية جديدة. وبعد سنوات أو عقود، يظهر عالم في مجال آخر فيكتشف أن هذه البنية هي الأداة التي يحتاج إليها لوصف النموذج قيد الدراسة، والتعرف على نمط تفاعل عناصره، بل والتنبؤ بسلوك النظام في ظروف محددة سلفًا ومثبتة رياضيًا. وهذا ما يجعل الرياضيات البحتة أداةً فعالة لمواجهة كثير من التحديات العملية، لا مجرد تراكم للقوانين والمعادلات، على الرغم مما يتسم به هذا الجانب من جمال في الصياغة وروعة في النسق. وبذلك يمكن القول إن الرياضيات البحتة سجلٌّ حافل بالأفكار التي تنتقل من التجريد إلى التطبيق، ثم تعود من التطبيق لتفتح أسئلة رياضية جديدة، فتستمر الدورة على النحو الآتي:
رياضيات بحتة ← نماذج وأدوات رياضية ← بيانات وتطبيقات ← مشكلات جديدة ← رياضيات جديدة.
وفي عصر الذكاء الاصطناعي، تبدو هذه الدورة أكثر وضوحًا من أي وقت مضى. فالطوبولوجيا مثلًا، وهي الفرع الذي يدرس بنية الفضاءات والخصائص التي تبقى محفوظة تحت التشوهات المستمرة، أصبحت من الأدوات التي تُستخدم لفهم البيانات المعقدة: كيف نصف البنى عالية الأبعاد؟ وكيف نتعامل مع الغموض (اللايقين)؟ وكيف نستخرج المعلومات البنيوية من البيانات الضخمة؟ وبذلك لا تكون الرياضيات البحتة مجرد أداة لحساب النتائج، بل إحدى اللغات الأساسية التي تساعد الإنسان على فهم البنية الخفية وراء النظم التي تصف كثيرًا من ظواهر الواقع من حولنا.
فمن خلال التحليل الطوبولوجي للبيانات يمكن دراسة البيانات لا بوصفها مجرد مجموعة من القيم العددية، بل بوصفها بنية هندسية تحمل خصائص وعلاقات داخلية. وتساعد هذه الرؤية على اكتشاف التجمعات والأنماط والحلقات والبنى المتصلة داخل البيانات، حتى حين تكون عالية الأبعاد ومعقدة بحيث يصعب تصورها بالطرق التقليدية. ومن ثم يمكن تحويل هذه الخصائص الطوبولوجية إلى سمات رياضية تستفيد منها خوارزميات التعلم الآلي في مهام التصنيف والتعرف على الأنماط.
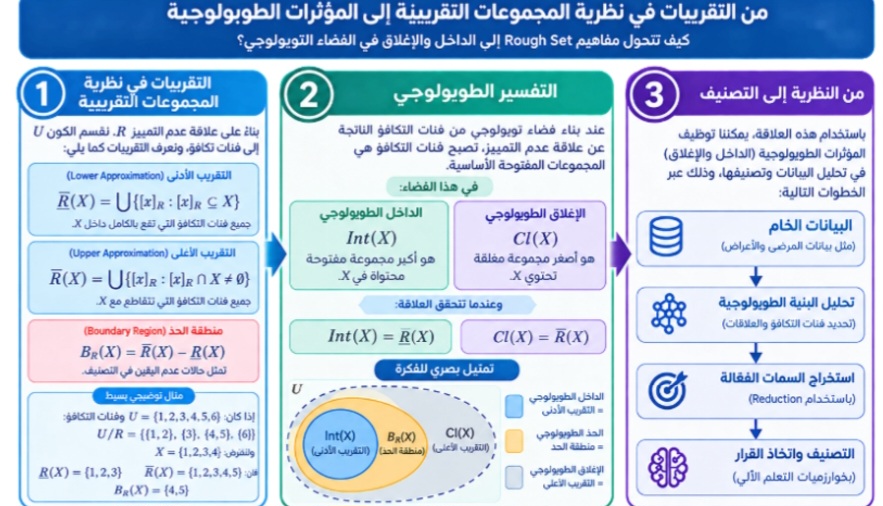
ولتوضيح الفكرة، سنرى كيف يمكن إنشاء بنية طوبولوجية مكافئة لنظام معلومات خاص بمجموعة من المرضى، بدلًا من الاكتفاء بالفضاءات التقريبية المعرَّفة من خلال مجموعة الاستقراب. فإذا كان لدينا عدد من المرضى، ولكل مريض مجموعة من الأعراض، فقد يظهر مريضان القيم نفسها في مجموعة معينة من الأعراض، ومن منظور هذه السمات وحدها لا نستطيع التمييز بينهما. وبالتالي يمكن جمع الحالات المتشابهة في مجموعات تسمى فئات عدم التمييز. وفي النموذج الكلاسيكي، يمكن بناء طوبولوجيا مناسبة انطلاقًا من فئات التكافؤ الناتجة عن علاقة عدم التمييز، بحيث تمثّل اتحاداتُ هذه الفئات "المجموعات المفتوحة" في فضاء طوبولوجي، وتمثّل النقاطُ الداخلية لمجموعة ما تقريبَها الأدنى، بينما تمثّل نقاط الإغلاق تقريبَها الأعلى. وهنا نكتشف أن العلاقة بين المجموعات التقريبية والطوبولوجيا أعمق من مجرد تشابه في المصطلحات؛ إذ يمكن التعبير عن التقريبات نفسها بلغة طوبولوجية.
لنفترض أن لدينا الجدول الآتي الذي يبيّن ست حالات افتراضية، وأننا نريد تصنيفها إلى فئتين مرضيتين بوصفهما قرارًا لحالة المريض. والغرض من هذا الجدول ليس تشخيص مرض حقيقي، وإنما توضيح كيفية عمل فكرة التصنيف الرياضي واختزال السمات. سنلاحظ أولًا أن المرضى P1 وP3 وP4 لهم السمات (الأعراض) نفسها، وكذلك المريضان P2 وP6، ولذا يمكن التعامل مع كل مجموعة من هذه الحالات المتطابقة بوصفها وحدة واحدة. وهذا ما يُعبَّر عنه رياضيًا بفئات عدم التمييز، وهي وحدة بناء الهيكل الطوبولوجي المكافئ لهذا النظام من المعلومات. وبإنشاء الطوبولوجيا الممثِّلة لهذا النظام المعلوماتي، نتمكن من حساب التقريبات المطلوبة ومناطق عدم اليقين وقياسات الدقة المرافقة لها، باستخدام المفاهيم الطوبولوجية المجردة، وهي النقاط الداخلية ونقاط الإغلاق والنقاط الحدية للمجموعات قيد الدراسة.
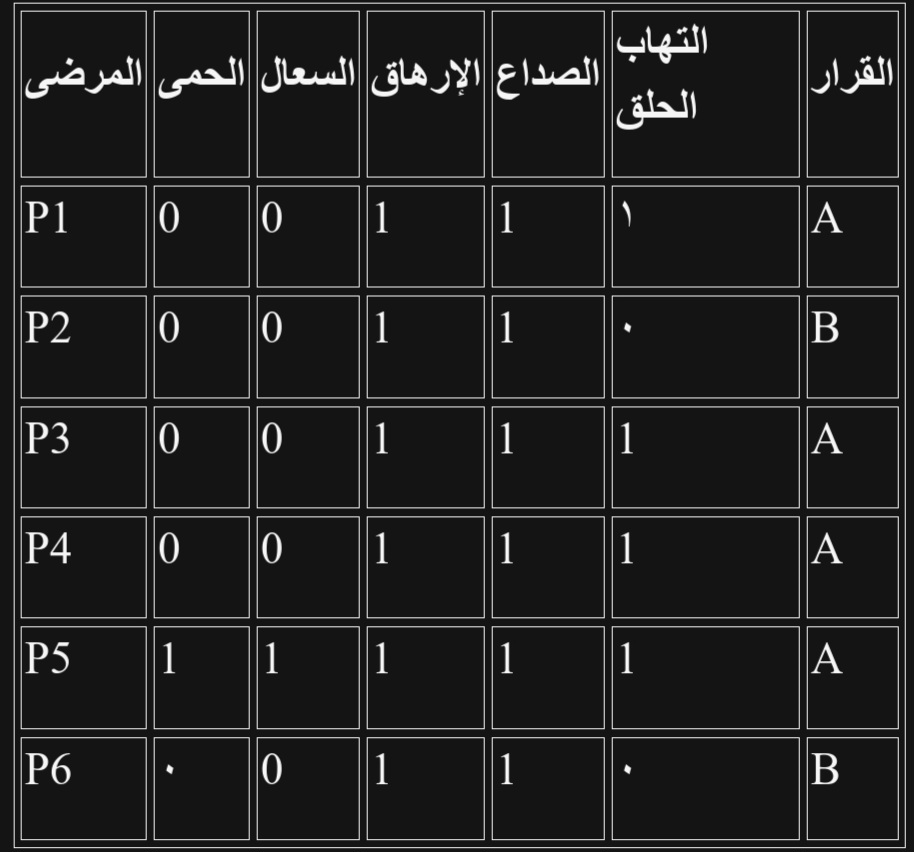
والآن، إذا استخدمنا الأعراض الخمسة كلها في عملية التصنيف، فإن لدينا المجموعة الكاملة من المعلومات. ولكن هل نحتاج فعلًا إلى جميع السمات الموجودة في البيانات لاتخاذ القرار؟ الإجابة في كثير من الحالات: لا. فقد تكون لدينا عشرات الأعراض أو القياسات، لكن عددًا صغيرًا منها قد يكون كافيًا للوصول إلى القرار نفسه. وهنا تظهر أهمية مفهوم اختزال السمات، وهو مجموعة فرعية من السمات تكفي للحفاظ على القدرة التمييزية الأساسية لمجموعة السمات الأصلية. ففي الجدول السابق نجد أن سمة «التهاب الحلق» وحدها تكفي للحصول على القرار نفسه، أي أننا لا نحتاج بالضرورة إلى الاحتفاظ بالأعراض الخمسة كلها حتى نحافظ على القدرة على التمييز بين الفئتين في البيانات المعطاة. وبذلك نعدّل التعليمات الموجهة إلى خوارزمية الذكاء الاصطناعي: فبدلًا من أن نقول لها «استخدمي كل المعلومات المتاحة»، يمكن أن نقول: «ابحثي أولًا عن المعلومات التي تحمل أكبر قدر من القدرة على التمييز، وتخلّصي من المعلومات الزائدة».
ولكن كيف نحدد ذلك باستخدام البنية الطوبولوجية المجردة؟ يتم ذلك بإنشاء الطوبولوجيا الناشئة من فئات عدم التمييز المتولدة عن جميع السمات المعطاة، ثم إنشاء الطوبولوجيا الناشئة عن السمات بعد استبعاد إحداها. فإذا حصلنا على البنية الطوبولوجية نفسها فهذا يعني أن السمة المستبعدة يمكن الاستغناء عنها. وهكذا نتمكن، عبر البنية الطوبولوجية، من تحديد السمة أو السمات التي تكفي للحصول على القرار نفسه الناتج عن جميع السمات.
والفائدة هنا ليست في حذف سمة أو سمتين أو أي عدد من السمات في حد ذاته، بل فيما يترتب على ذلك من فوائد مهمة في التطبيقات العملية، منها:
• تقليل حجم البيانات: يقل حجم البيانات التي يعالجها النظام، مما يوفر الزمن والطاقة اللازمين للحصول على النتائج.
• تقليل التعقيد: يصبح النظام أبسط وأسهل في التحليل والفهم عند الاعتماد على عدد أقل من المتغيرات.
• التخلص من السمات غير المؤثرة: وهي السمات التي لا تضيف شيئًا مختلفًا في التمييز بين الفئات.
• تحسين قابلية التفسير: فعندما نقول إن القرار يعتمد بصورة أساسية على سمات محددة، يصبح من الأسهل تفسير كيفية الوصول إلى النتيجة.
• رفع كفاءة التعلم الآلي: فعند استخدام مجموعة مناسبة من السمات بدلًا من مجموعة ضخمة، يمكن أن تصبح عملية التدريب والتصنيف أكثر كفاءة، مع ضرورة التحقق تجريبيًا من تأثير الاختزال على الدقة في كل تطبيق حقيقي.
وفي السنوات الأخيرة، ومع التطورات المعاصرة في تحليل البيانات، برزت الأفكار المجردة بوصفها أدوات فعالة لفهم البيانات المعقدة واكتشاف بنيتها الداخلية. ومن ذلك ما يُعرف بـالتحليل الطوبولوجي للبيانات (Topological Data Analysis - TDA)، وهو منهج يحاول النظر إلى البيانات بطريقة مختلفة عن الأساليب التقليدية. فبدلًا من التعامل مع البيانات بوصفها مجرد مجموعة كبيرة من الأرقام، نطرح سؤالًا أعمق: ما الشكل أو البنية التي تكمن وراء هذه الأرقام؟ فإذا كانت لدينا مجموعة ضخمة من البيانات، فإن كل نقطة فيها يمكن أن تمثل شيئًا معينًا: صورة، أو مريضًا، أو إشارة من جهاز استشعار، أو تسجيلًا صوتيًا، أو مستخدمًا، أو نتيجة تجربة علمية. ومع زيادة عدد الخصائص التي تصف كل عنصر، توجد البيانات في فضاء عالي الأبعاد يصعب علينا تخيله أو رسمه مباشرة. ومع ذلك، قد تكون لهذه البيانات بنية داخلية واضحة حتى لو لم نستطع رؤيتها بسهولة. وهنا تكمن قوة المنظور الطوبولوجي في استكشاف البيانات قبل التصنيف، وليس بعده فقط.
فلنتخيل باحثًا يمتلك ملايين القياسات، ولكنه لا يعرف مسبقًا كيف تنقسم هذه البيانات إلى مجموعات. قد تبحث الطرق التقليدية عن تشابهات عددية بين العناصر، بينما يستطيع المنظور الطوبولوجي استخلاص بنية هندسية أو طوبولوجية تجعل بعض العناصر أقرب إلى بعضها من الناحية البنيوية. وهذا فرق مهم؛ فالذكاء الاصطناعي لا يحتاج دائمًا إلى أن نخبره مسبقًا بما نبحث عنه، بل قد يكون الهدف مساعدته على اكتشاف بنية لم نكن نعرف بوجودها أصلًا.
آلية عمل التحليل الطوبولوجي للبيانات
من النقاط إلى البنية: لنفترض أن لدينا آلاف البيانات التي تظهر في البداية كسحابة من النقاط. قد تحتوي هذه السحابة على مجموعات منفصلة، أو مناطق مترابطة، أو بنى تشبه الحلقات، أو فراغات داخلية. وقد لا تكون هذه الخصائص واضحة عند النظر إلى القيم العددية وحدها، لكنها تصبح أوضح عندما ندرس العلاقات بين النقاط. وتستطيع أدوات التحليل الطوبولوجي أن تبحث عن مثل هذه الخصائص، ومنها عدد المكونات المتصلة، والحلقات، والفراغات أو التجاويف ذات الأبعاد المختلفة. وهذه الخصائص لا تعتمد فقط على الموقع الدقيق لكل نقطة، بل تحاول التقاط البنية العامة للبيانات.
ولتبسيط الفكرة، يمكن أن نتخيل دائرةً من البيانات. فإذا تغير شكل الدائرة قليلًا، أو امتدت أو انحنت، فإنها تظل في جوهرها تحتوي على حلقة واحدة. وبالمثل، إذا تشوّه جسم هندسي بطريقة مستمرة دون أن تتغير بنيته الأساسية، فإن بعض خصائصه الطوبولوجية تبقى محفوظة. وهذه القدرة على التركيز على البنية بدلًا من التفاصيل الشكلية الدقيقة هي التي تجعل الطوبولوجيا مثيرة للاهتمام في دراسة البيانات المعقدة.
كيف تتحول هذه الفكرة إلى أداة للذكاء الاصطناعي؟
يمكن تصور العملية في ثلاث مراحل رئيسة:
المرحلة الأولى: البيانات الخام. تبدأ العملية بمجموعة كبيرة من البيانات، قد تكون صورًا، أو إشارات، أو قياسات، أو سجلات رقمية. وفي هذه المرحلة قد تبدو البيانات معقدة جدًا، خصوصًا عندما يكون لكل عنصر عدد كبير من الخصائص.
المرحلة الثانية: اكتشاف البنية الطوبولوجية. يُنظر إلى البيانات بوصفها نقاطًا في فضاء ما، ثم تُدرس العلاقات بينها. ومن خلال بناء تمثيلات شبكية أو هندسية للبيانات يمكن البحث عن المكونات المتصلة والحلقات والفراغات وغيرها من الخصائص. ومن الأدوات المهمة هنا ما يُعرف باسم التماثل المستمر (التجانس المستمر) (Persistent Homology)، الذي لا يكتفي باكتشاف بنية معينة عند مقياس واحد، وإنما يتابع ظهورها واختفاءها عند تغيير مقياس النظر إلى البيانات. فإذا ظهرت خاصية طوبولوجية واستمرت عبر نطاق واسع من المقاييس، فقد يكون ذلك مؤشرًا على أنها جزء حقيقي من بنية البيانات وليست مجرد ضوضاء عابرة.
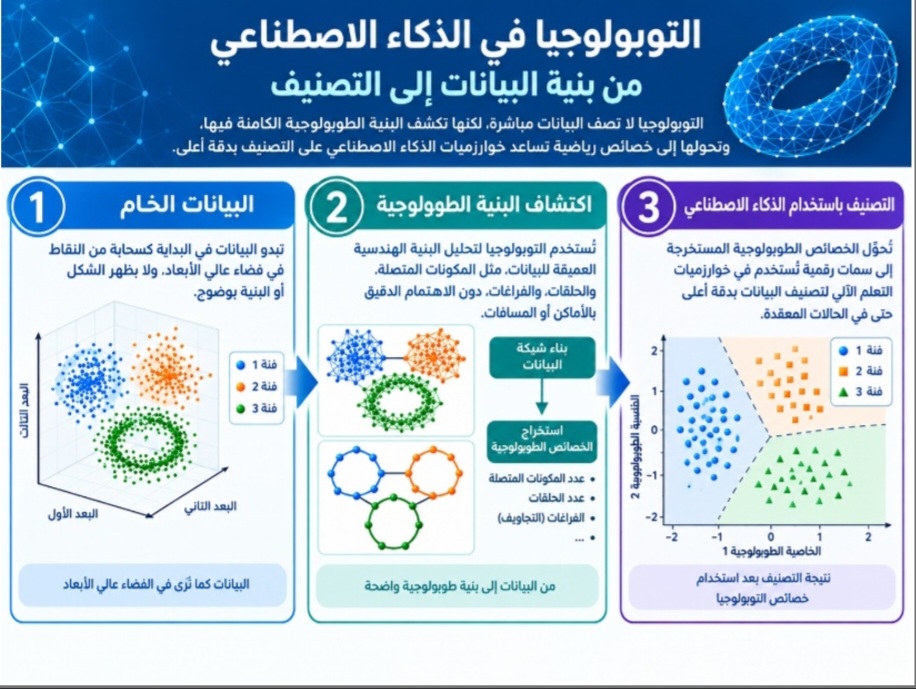
المرحلة الثالثة: تحويل الخصائص إلى معلومات يستفيد منها التعلم الآلي. بعد استخراج الخصائص الطوبولوجية، يمكن تمثيلها في صورة سمات رقمية أو تمثيلات مناسبة، ثم إدخالها في خوارزميات التعلم الآلي إلى جانب خصائص أخرى. وهنا لا تقوم الطوبولوجيا بالضرورة بعملية التصنيف وحدها، وإنما توفر للذكاء الاصطناعي وصفًا إضافيًا لبنية البيانات يمكن أن يساعده على التمييز بين الفئات المختلفة. وفي النقاط الآتية نوضح هذه الفكرة أكثر:
(1) التمييز بين مجموعات البيانات: لنفترض أن لدينا بيانات تنتمي إلى ثلاث فئات مختلفة. قد تكون الفئات متقاربة من حيث بعض القيم العددية، ولذلك يصعب على طريقة بسيطة الفصل بينها. لكن عند دراسة البنية العامة للبيانات قد نجد أن إحدى الفئات تتكون من تجمع متصل، بينما تظهر فئة أخرى في شكل بنية حلقية، في حين تتوزع الفئة الثالثة في تجمع مختلف. وفي هذه الحالة تصبح البنية الطوبولوجية نفسها معلومة مفيدة للتصنيف؛ فالخوارزمية لا تعتمد فقط على «أين تقع النقطة؟»، وإنما يمكن أن تستفيد أيضًا من معرفة كيف ترتبط هذه النقطة ببقية البيانات؟ وما البنية التي تنتمي إليها؟
(2) الصور: الصورة الرقمية في أبسط صورها مصفوفة من الأعداد تمثل شدة الألوان أو درجات الإضاءة، لكنها في حقيقتها تحمل بنية أكثر تعقيدًا: حدودًا، ومناطق متصلة، وتجاويف، وأشكالًا، وتدرجات. فلنتخيل مثلًا صورة لجسم يحتوي على فتحة أو تجويف واضح؛ قد تكون هذه الخاصية جزءًا مهمًا من شكل الجسم، ويمكن للتحليل الطوبولوجي أن يلتقط وجود مثل هذه البنية بطريقة مختلفة عن تحليل كل بكسل على حدة. وهذا يفتح الباب أمام استخدام الخصائص الطوبولوجية بوصفها إحدى السمات التي يمكن أن يستفيد منها نظام التعلم الآلي عند تحليل الصور.
(3) الإشارات والبيانات الزمنية: لا يقتصر الأمر على الصور؛ فلدينا اليوم كميات هائلة من البيانات التي تتغير مع الزمن، مثل إشارات أجهزة الاستشعار، والبيانات البيئية، والنشاطات التي تسجلها الأجهزة، والإشارات الفيزيائية، وغيرها. وقد تبدو الإشارة سلسلة طويلة من الأرقام، لكنها قد تحتوي على أنماط متكررة أو تغيرات بنيوية يصعب اكتشافها بمجرد النظر إلى القيم الفردية. وهنا يمكن استخدام الأساليب الطوبولوجية لتحويل بعض خصائص البنية العامة للإشارة إلى سمات رياضية يمكن تحليلها ومقارنتها.
(4) البيانات الطبية: من التطبيقات المثيرة للاهتمام أيضًا تحليل البيانات الطبية، إذ قد تحتوي بيانات المرضى على عدد كبير من المتغيرات في الوقت نفسه، ويصعب فهم العلاقات بينها بتحليل بسيط لكل متغير على حدة. ويمكن للمنظور الطوبولوجي أن يساعد في البحث عن بنية البيانات: هل توجد مجموعات طبيعية من الحالات؟ وهل توجد مناطق انتقال بين المجموعات المختلفة؟ وهل هناك أنماط أو هياكل متكررة داخل البيانات؟
وفي الختام، نخلص إلى أن العلاقة بين الطوبولوجيا والذكاء الاصطناعي تكشف لنا شيئًا أعمق من مجرد تطبيق رياضي جديد. فهي توضح أن الفكرة الرياضية قد تولد في سياق نظري بعيد كل البعد عن التطبيق، ثم تمر عقود أو قرون قبل أن تظهر الحاجة إليها في مجال علمي أو تقني جديد. فالمفاهيم المجردة التي تبدو في البداية بعيدة عن الحياة اليومية قد تصبح، مع تغير أسئلة العلم والتكنولوجيا، أدوات أساسية لفهم ظواهر جديدة. وهنا تتضح قيمة الرياضيات البحتة؛ فهي لا تحتاج دائمًا إلى تطبيق مباشر عند ولادتها، وإنما يوسّع بناء النظريات والمفاهيم المجردة «صندوق الأدوات» الذي يمكن للأجيال القادمة من العلماء والمهندسين استخدامه في حل مشكلات لم تكن موجودة أصلًا عند نشوء تلك النظريات.